背景:我英语不好,想每天多接触英文单词,但遇到不认识的词又不想切出去单独查翻译。 这篇文章记录了为了解决这个问题,我在 OpenCode 里做的一套东西:碰到了哪些问题、怎么解决的、提示词怎么评估的,以及最终成品长什么样。
一、需求是怎么来的
学英语最怕的不是难,是中断。
正常的阅读流程是这样的:
- 读到一个不认识的词;
- 停下来,切窗口,打开词典;
- 查完切回来,已经忘了前半句在讲什么;
- 于是放弃,继续用中文。
问题不在词典,在于「查」这个动作本身破坏了阅读的连贯性。
所以我想要的其实是两件事:
- 不想查:不认识的词,意思应该直接出现在眼前,不要让我离开句子。
- 想多接触:每天读的东西里,英文单词的密度要高,而且要能反复见到。
于是就有了这个方案:让 AI 的回复本身变成教材。
二、方案:两层阅读
核心思路一句话:把词义放在词后面,把深度查询放在一个按键之外。
具体分两层:
| 层级 | 形式 | 成本 | 用途 |
|---|---|---|---|
| 第一层:行内注释 | **stale**(过时的) 直接跟在单词后面 | 免费,自动 | 保持阅读流畅,不打断 |
| 第二层:卡片查询 | /dict stale 弹出完整词卡 | 免费,离线 | 回答第一层留下的疑问 |
第一层负责「不中断」,第二层负责「查得深」。
三、成品截图
1. 行内注释:回复里自动带中文
每条回复里,超出基础词汇的英文词后面都会跟上中文小注。这样读的时候可以先猜,猜不出来再看括号。
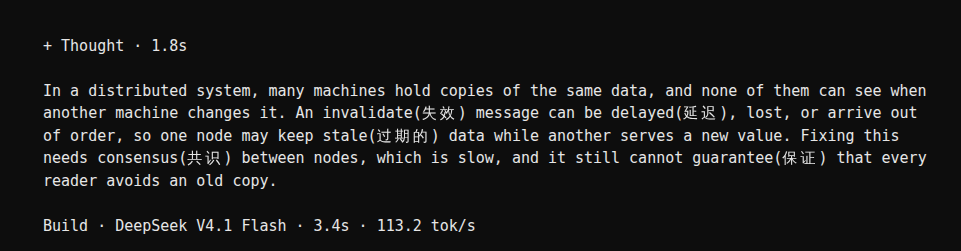
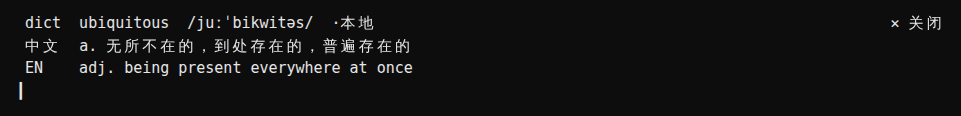
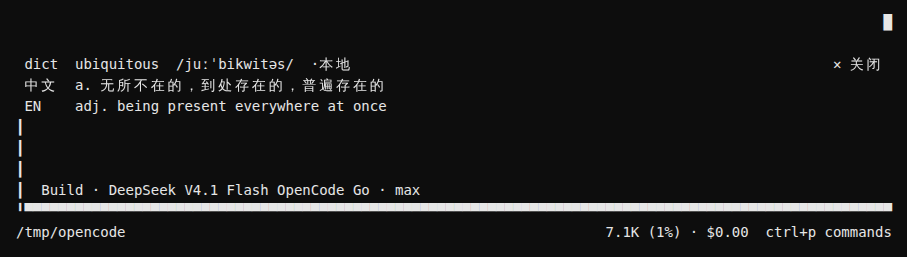
2. /dict:离线单词卡
输入 /dict ubiquitous,输入框上方立刻出现词卡:音标、中文释义、英文解释。标题右侧的 ·本地 表示这个词来自本地词典,没有联网。
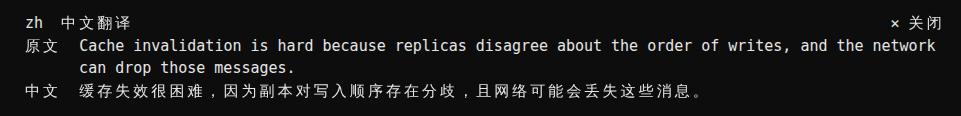
3. /zh:整句翻译卡
一句话看不懂,直接 /zh 贴进去。长文本会自动换行,不会截断。
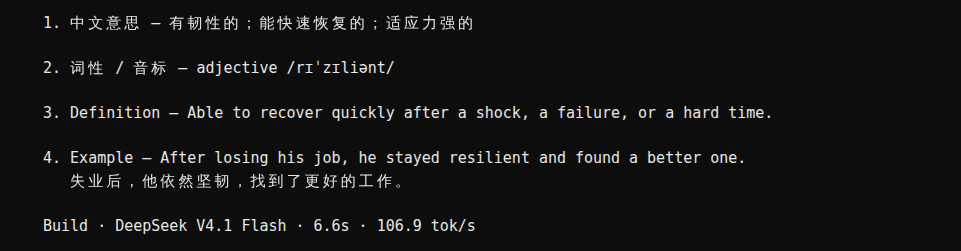
4. /word:学习型词条
如果这个词你不仅要认识,还想记住,就用 /word。它会给出中文意思、词性音标、英文定义,以及一个带翻译的例句。
5. 卡片出现的位置
卡片渲染在输入框上方,不进入对话正文,也不占用模型上下文。
四、四个组成部分
4.1 回复风格规则(AGENTS.md)
这是整套方案的发动机。在 OpenCode 的 ~/.config/opencode/AGENTS.md 里写清楚「回复该怎么写」:
## Language

- Reply in English. The user is a Chinese speaker practising English and wants to
  read English every day.

## Write simply and clearly

- Start with the answer in one short line. Add detail only if it helps.
- One idea per sentence. Keep sentences under about 20 words.
- Prefer plain verbs and everyday nouns over abstract wording.
- Avoid idioms, wordplay, and deeply nested clauses. They are hard to parse.
- Cut filler: no praise, no restating the question, no summary of a summary.

## Mark uncommon words

- Wrap an advanced or uncommon English word in **bold**, and put its Chinese
  meaning in parentheses right after it, like **ubiquitous**(无处不在的).
- Gloss every word a beginner textbook would not contain. If a word is ordinary
  (make, small, because, problem) skip it; otherwise mark it.
- Expect 8 to 12 marked words in a normal reply.
- Finishing with five or fewer means you were too strict — go back and add the
  missing ones before sending.
- The one exception is a very short reply, under about 80 words: 3 to 5 is enough.
- Gloss a word at most once per reply, and never again a word you already glossed
  earlier in the same conversation.
两个要点:
- 先让英文可读。句子短、没有习语、没有废话,否则注释再多也读不下去。
- 再让生词可见。明确写出「什么算生词」(课本里不会出现的词)和「大概多少个」(8 到 12 个)。
4.2 /dict:离线词典
数据来自 ECDICT 词库,我把它转成了一个 SQLite 快照:
- 体积 327 MB
- 340 万条词条(ECDICT 基础词表是 77 万,这个数字包含了词形变化等扩展条目)
- 单次查询约 0.013 毫秒
- 支持词形变化(
running→run)
完全离线,不需要 API key,不消耗 token。这一点很重要:一个学习者每天会查几十个词,只要每次查询有成本,这个习惯就会死掉。
4.3 /zh:句子翻译
长句、段落翻译,走一条降级链:
- 自己的 key(Hy-MT2,腾讯云 TokenHub)
- 有道免费接口
- MyMemory
- 离线逐词注释(会明确标注「这是逐词翻译」)
有 key 的时候质量最好;没有 key 也能用,只是慢一点、差一点。
4.4 /word:学习型词条
这是一个斜杠命令文件 ~/.config/opencode/commands/word.md,内容就是提示词模板:
---
description: Explain one English word like a learner's dictionary
---

Explain the English word "$ARGUMENTS" for a Chinese learner. Reply with exactly
these four parts, in this order:

1. 中文意思 — the common senses only, on one short line
2. 词性 / 音标 — part of speech, then the phonetic spelling
3. Definition — one simple English sentence
4. Example — one example sentence, then its Chinese translation on the next line

Keep it short. Do not add etymology, a synonym list, or usage history.
比如查 resilient,输出长这样(对应上面的截图):
1. 中文意思 — 有韧性的;能快速恢复的;适应力强的
2. 词性 / 音标 — adjective /rɪˈzɪliənt/
3. Definition — Able to recover quickly after a shock, a failure, or a hard time.
4. Example — After losing his job, he stayed resilient and found a better one.
             失业后,他依然坚韧,找到了更好的工作。
为什么要单独做成命令?因为这段格式说明只在「查词」时才需要。放在 AGENTS.md 里,它会跟着每一个请求发送,白花 token。
五、关键设计:卡片不进入上下文
这是整套东西里最重要的一条设计,也是最容易被忽略的。
所有卡片都由一个 TUI 插件绘制,渲染在 session.composer.top 这个插槽上。卡片内容不会进入对话上下文。
实测验证:在一个独立会话里连续查了很多次词,会话的 token 计数完全没有变化:
input = 7169 output = 141 # 多次查询前后完全一致
这件事决定了方案能不能长期用下去:
- 查 30 个词,消耗 0 token;
- 对话记录里不会堆满词典内容;
- 不会因为「查词」而污染上下文、影响后续对话质量。
六、过程中踩的坑和解法
这部分才是真正花时间的地方。
6.1 卡片把长文本截断了
最早实现里有一行 text.slice(0, 160),本意是防止卡片过高,结果粘贴长句子做 /zh 时,翻译卡只显示前 160 个字符,后面直接没了。
改成按终端宽度真正换行、卡片高度限制为面板的一半之后就好了。一个小细节:换行宽度比面板宽 2 列,因为中文标点是全角的,严格按宽度断行会把收尾的「。」「,」挤到下一行行首,很难看。
6.2 卡片关不掉
查完词,卡片一直挂在输入框上面,只能重启。后来加了三套关闭方式:alt+x 快捷键、卡片标题栏右侧的 ✕ 关闭 按钮、命令面板里的 Lookup: close the card。
鼠标按钮是真的调用了渲染层的 onMouseDown,用 tmux 注入真实的 SGR 鼠标事件验证过:点击后卡片确实消失。
6.3 **bold** 在这个 TUI 里不是粗体
我以为 **word** 会渲染成粗体,抓取渲染结果发现它是粉色文字(247;85;144),不是粗体单元格。视觉信号依然有效(生词是粉色的,很显眼),只是名字叫「bold」而已。
这个发现值得记下来:规则文档里的描述和实际渲染效果可能不一致,要实测确认。
6.4 想让插件自动注释,但做不到
最初的想法更激进:既然插件已经有离线词典,为什么不直接让插件扫描 AI 的回复,自动给生词加上中文?
查了插件 API 之后确认不行:
session.hook("context")只能拿到输入侧的消息,改不了模型输出;- TUI 的插槽树里没有「对话正文」这个插槽,无法拦截渲染。
所以注释只能由模型自己生成。这引出了第七节要回答的问题:模型到底会不会乖乖加注释?
6.5 规则文档本身有成本
AGENTS.md 会跟着每一个请求发送。实测大约 461 token/请求。
解法:把只在特定场景才用的内容搬进斜杠命令。比如查词格式说明(原本 69 token)搬进 /word 之后,AGENTS.md 降到约 433 token/请求。
顺便纠正我自己一个错误:我一开始说这能省 69 token,其实我保留了一句指向命令文件的提示,所以实际只省了不到 30 token。说数字之前要真的量一遍。
七、提示词怎么评估
这是整件事里最有意思的部分,因为我一开始想当然,被打脸了。
7.1 评估方法
思路很土但有效:同一个提示词,跑很多次,数注释词的数量。
具体做法:
- 用 tmux 起一个全新的 OpenCode 会话(
tmux new-session -d -s gm -x 120 -y 50 "opencode"); - 等待约 26 秒(插件在启动时加载);
- 发送同一个问题:
Explain in 3 sentences why cache invalidation is hard in distributed systems.; tmux capture-pane -p抓取屏幕文本;- 用正则
([A-Za-z][A-Za-z-]{2,})\(([\u4e00-\u9fff][^)]{0,6})\)统计注释数量; - 用
opencode api get /api/session读会话的 token 消耗。
关键点:必须用全新会话,而且不能在当前会话里测。因为当前会话的 token 计数会被我自己的回复污染,测出来的数字没有意义。
7.2 各个变体的结果
同一道题,不同提示词写法的结果:
| 提示词变体 | 注释词数 | 备注 |
|---|---|---|
| 「自由标注,不要吝啬」 | 2, 5 | 太少,约束太软 |
| 「配额 5-10 个」 | 5, 5 | 稳定,但偏少 |
| 「期待 8-12 个 + 少于 5 个就重写」 | 10, 9 | 最好,但样本只有 2 次 |
| 「按长度缩放:每 15 词 1 个」 | 3, 4 | 反而不行,约束被理解成了「随便」 |
| 「期待 8-12 + 自检 + 短回复例外」 | 0, 8, 5 | 波动极大,甚至出现 0 |
把 11 次采样合在一起:
2, 5, 5, 5, 10, 9, 3, 4, 0, 8, 5
中位数 = 5,范围 = 0 ~ 10
7.3 三条结论
- 模型对「数量」的服从度很低。 同一句话,可能给 10 个注释,也可能给 0 个。规则能抬高平均值,但保证不了单次。
- 有自检句的版本明显更好。 「如果少于 5 个,说明你太保守了,回去补上」这句话,比任何「期望 8-12 个」都管用。它把统计目标变成了一个可执行的检查动作。
- 不要过度调参。 我试了 5 个变体,样本量都在 2-3 次,波动比差异还大。这种情况下继续改措辞是在拟合噪声。样本不够时,最该做的是增加样本,不是改提示词。
八、日常怎么用
- 先读英文,再看括号。 每个带注释的词,先猜一遍意思,再对答案。
- 卡住的词用
/dict。 免费、瞬时,所以不要犹豫,看到就查。 - 想记住的词用
/word。 重点读例句,读两遍。 - 整句卡住用
/zh。 长段落也可以直接贴。 - 能回英文就回英文。 输出比输入更能建立语感。
九、成本与隐私
- 查词卡片:0 token,完全离线(
/dict全程不联网)。 - 句子翻译:优先用自己的 key;不配 key 也能用免费链路。
- 行内注释:这部分由模型生成,会产生正常的 token 消耗,但没有额外调用。
- 隐私:
/dict的内容不会离开本机。句子翻译如果走免费接口,文本会发给对应服务商;走自己的 key 则发给 TokenHub。
十、已知限制和下一步
限制:
- 行内注释的数量不可控,只能保证长期均值(见第七节)。
- 无法让插件自动注释,因为插件 API 没有「输出侧」钩子。
- 免费翻译接口随时可能失效。
下一步可以考虑:
- 做一个生词本:每次
/dict自动记录,配一个/review命令做间隔重复复习。 - 让模型不要重复注释「我已经注释过的词」(目前已加同会话去重规则,跨会话还做不到)。
附录:文件清单
以下路径都在跑 OpenCode 的服务器(lsf-server)上:
| 路径 | 作用 |
|---|---|
~/.config/opencode/AGENTS.md | 回复风格规则(英文、短句、行内注释) |
~/.config/opencode/commands/word.md | /word 命令的提示词模板 |
~/.config/opencode/plugins/lookup/ | 插件本体:卡片渲染、翻译链路、离线查询 |
~/.local/share/lookup/dict.db | 327 MB 离线词典快照(ECDICT → SQLite) |
一句话总结:不要主动去查词,让词带着意思来找你;只把那些仍然卡住你的词,交给一个免费、瞬时的词典。